通义千问和豆包哪个更好?按任务选择更实用
通义千问和豆包没有脱离任务的绝对胜者。长期选择可以把自己的高频工作分别交给两者测试。资料变成可交付文件、处理较完整任务,可考察千问的任务和成品能力。日常问答、搜索、写作或临时创作,也应实际体验豆包的回复与后续修改。两者都需要人工核验,价格、政策、版本和专业事实尤其如此。
通义千问和豆包的当前公开能力
| 比较角度 | 通义千问 | 豆包 |
|---|---|---|
| 公开入口描述 | 应用页列出问答、工作、任务、PPT、翻译、写作和生图生视频等入口。 | 应用页定位为随时帮忙的AI助手,并展示问答、搜索、写作、翻译和PPT等入口。 |
| 任务型场景 | 页面描述可交付网页、应用、PPT、Word、Excel和图片等成品文件。 | 页面展示工作任务模式以及多轮对话、搜索、文档、表格和创作相关能力。 |
| 实际比较重点 | 文件是否读对、格式是否完整、能否继续修改和交付。 | 问题是否答到点上、创作是否符合要求、追问后能否保持上下文。 |
产品界面、模型、会员与可用额度会不断更新,表中的内容只反映当前页面呈现的方向。对某项能力,先在自己的账号和设备上打开一次,再决定它是否适合自己的工作流。
通义千问可用成品任务做实测
千问的应用页把【工作】、【任务】和多种成品格式放在显眼位置。报告、PPT、表格、图片或一组材料类任务,可上传真实但不含敏感信息的样本,写明受众、字数、固定栏目和禁止改动的事实。观察材料是否读全、生成的文件能否打开,以及第二轮修改会不会破坏原来的结构。
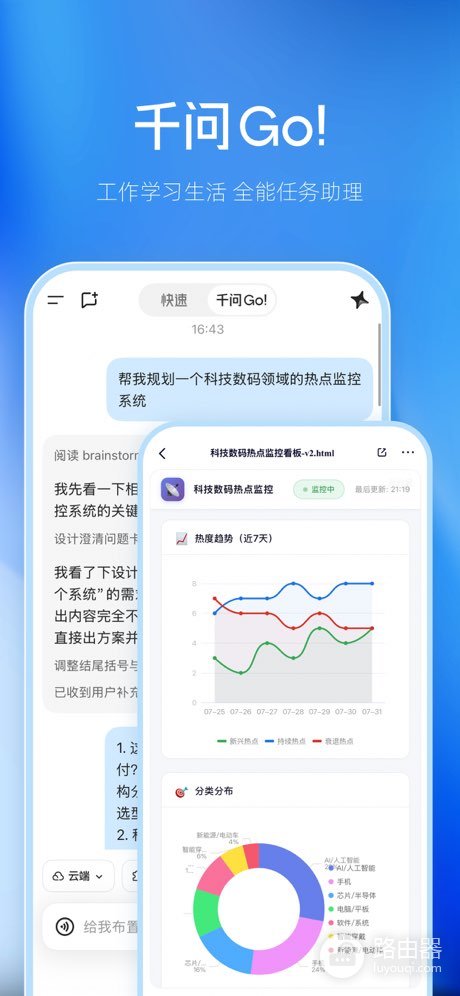
这类测试的价值在于看交付过程,而不是只比较第一段回答写得是否漂亮。比如让两个助手都把会议记录改成待办清单,再要求补上负责人、按固定模板输出、删去猜测内容。谁能连续遵守这些条件,并让你少花时间返工,谁才更贴合这项任务。
豆包可用日常对话和创作需求做实测
豆包页面将自己描述为随时帮忙的AI助手,内容覆盖问答、搜索、写作、翻译、PPT及工作任务等。写邮件、改标题、拆解陌生概念、整理零散想法,可用同一份材料和同一条提示发给它,再看它是否抓住限制条件、表达是否符合受众、追问后有没有偏离原题。
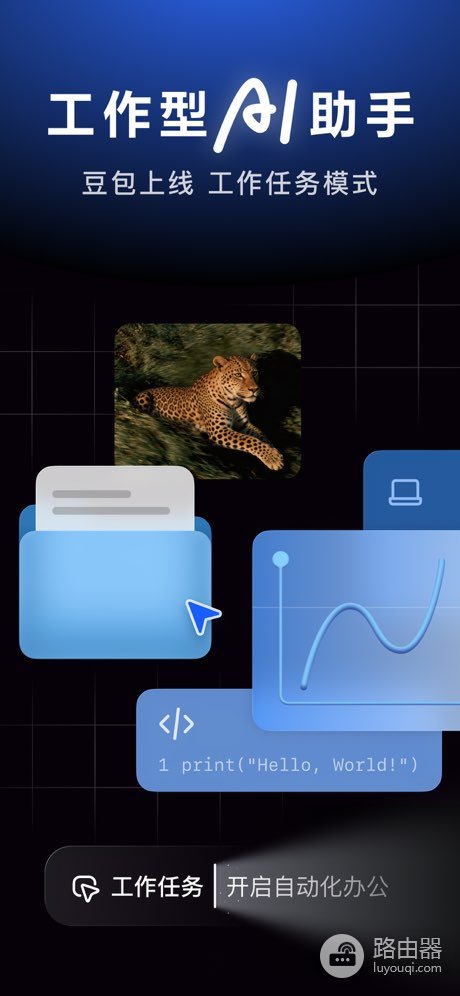
不要把宣传图中的工作任务模式理解为每个账号都能获得完全相同的功能。地区、设备、账号状态和客户端版本都会影响入口。文档、表格或自动化任务,直接在当前页面验证入口和结果,比根据旧攻略判断更可靠。
用同一题目做三轮测试再选
1、准备真实任务
选一项一周内会重复做的工作,例如把一段需求改成执行清单、依据资料写一封邮件,或解释一段报错。给两边相同的原始材料、目标读者、字数、输出格式和不能出现的内容。
2、比较第一轮结果
看答案有没有直接解决问题,有没有遗漏材料里的关键限制,是否把未知内容编成确定事实。引用或数据要标出可核验的来源,不能把模型生成的链接和数字直接交付。
3、继续追问两轮
要求缩短、调整语气、补足遗漏步骤,或改成你常用的模板。连续改写后仍保留原有事实、格式和限制条件的助手,能明显降低后续编辑成本。
最终选择看复核成本和使用习惯
文件和成品型工作,优先比较千问在实际材料、格式和任务交付上的稳定性。日常问答、内容草稿和随手创作,可重点比较豆包在同题对话和多轮修改中的可用程度。这个区分不是能力高低排名,两者的功能范围也会交叉。
医疗、法律、财务、新闻、软件版本、会员价格或购买决策,AI的答案只能作为起点。回到原始文件、应用内当前介绍或权威页面复核。连续试用几天后,选择那个在你的常见任务上更少跑偏、需要改得更少、又能让你保留最终判断权的工具,才是更好的答案。