WinDbg如何分析死锁?WinDbg怎样确认线程等待闭环
用WinDbg分析死锁,不是看到线程停在等待函数里就下结论。在用户态转储中执行 !locks,找出被锁住的临界区和持有线程,再用 ~ 对照线程号、用 kb 看每个持有者还在等什么。只有“线程A持有锁1等锁2,线程B持有锁2等锁1”能连成一圈,才能把问题定为死锁。
WinDbg分析死锁:把锁、线程和堆栈连起来
1、让符号和转储处于可读状态
打开卡死时取得的进程转储,或附加到已经无响应的进程后,检查调用栈里能否看到模块和函数名。堆栈大多是地址或问号,先处理符号加载再追锁关系。符号不完整会让系统等待框架看起来像业务代码的根因。
2、运行 !locks,记下被持有的临界区
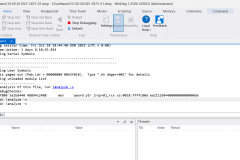
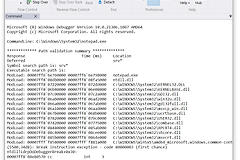
在用户态调试器中直接输入 !locks 即可列出当前进程的临界区。记下标为锁定的条目、其地址和 OwningThread。没有被锁住的条目不需要进入后续链路。下面的命令窗口就是这一步的界面,扫描结束后应回到提示符,而不是把“扫描到若干临界区”本身当作死锁证据。
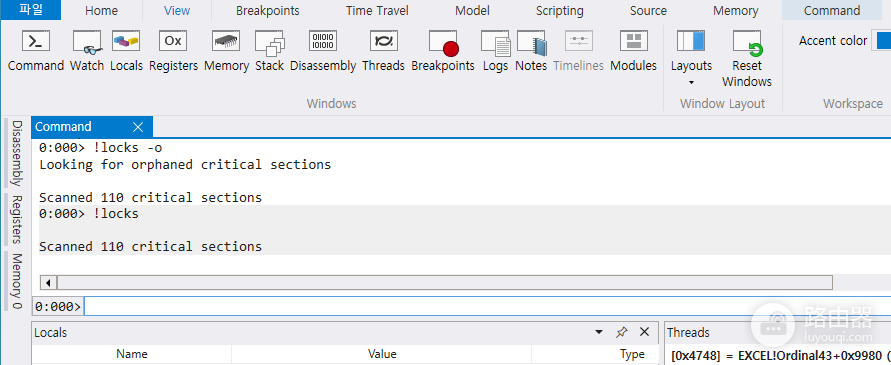
!locks
~
3、把持有线程号换成WinDbg线程号
!locks 输出的是持有者的线程ID,~ 列表同时给出调试器内部线程号和ID。匹配后,例如持有者对应第4条线程,就执行 ~4 kb。对每一条仍持锁的线程都做同样的检查,而不是只盯着当前线程。
~4 kb
~6 kb
4、从堆栈写出“谁等谁”
如果栈中出现 WaitForCriticalSection、RtlpWaitForCriticalSection 或进入临界区的相关调用,就继续核对它正在等待的临界区地址。把记录整理成两行:线程4持有锁A,等待锁B。线程6持有锁B,等待锁A。两条边回到起点,就得到了可复核的死锁闭环。
看到等待后,怎样证明它不是普通卡顿
单条线程停在等待函数里很常见,可能在等待I/O、定时器、消息或一条最终会释放锁的工作线程。判断时不要只看 LockCount 或某一帧函数名,而要同时保留持有关系和等待关系。
| 观察到的现象 | 下一步判断 |
|---|---|
| 某线程等待临界区 | 找到该临界区的持有者,再看持有者堆栈。 |
| 持有者仍在计算或处理外部工作 | 它可能只是慢,稍后释放锁后等待会结束。 |
| 两个或更多线程互相等待 | 关系回到起点,才能确认死锁并回看锁获取顺序。 |
| 链条没有闭合 | 继续查第三个持有者,或检查I/O、事件和消息等外部依赖。 |
闭环确认后,回到两条堆栈里最靠近业务代码的加锁位置。常见修复是统一同一组锁的获取顺序,缩短持锁范围,并避免在持锁期间进行可能阻塞、回调或再次申请另一把锁的操作。修改后按相同复现步骤再抓一次转储,确认原来的等待环已经消失。
核心态转储要换到对应扩展
上面的 !locks → ~ → kb 链路用于用户态临界区。分析核心态转储可直接输入 !locks,它会使用内核的 !kdexts.locks 来列出内核资源锁和持有线程。不要把两种上下文的输出字段混在一起解释。
!locks
!kdexts.locks
!deadlock
!deadlock 不是任意转储都能替代手工分析的万能命令,它与Driver Verifier配合,用来发现代码中不一致的加锁方式。缺少这一前提,仍应从锁持有者和线程堆栈出发,证明等待关系是否闭合。遇到排队自旋锁或框架对象,也应改用与对象类型匹配的扩展,而不是强行从临界区输出推断。
最终要留下的不是“程序曾经卡住”的描述,而是一条能被别人复查的链:哪条线程持有什么、又在等什么、下一条边如何回到原线程。这样无论是调整锁顺序,还是拆分临界区,修复结果都能用新的转储验证。